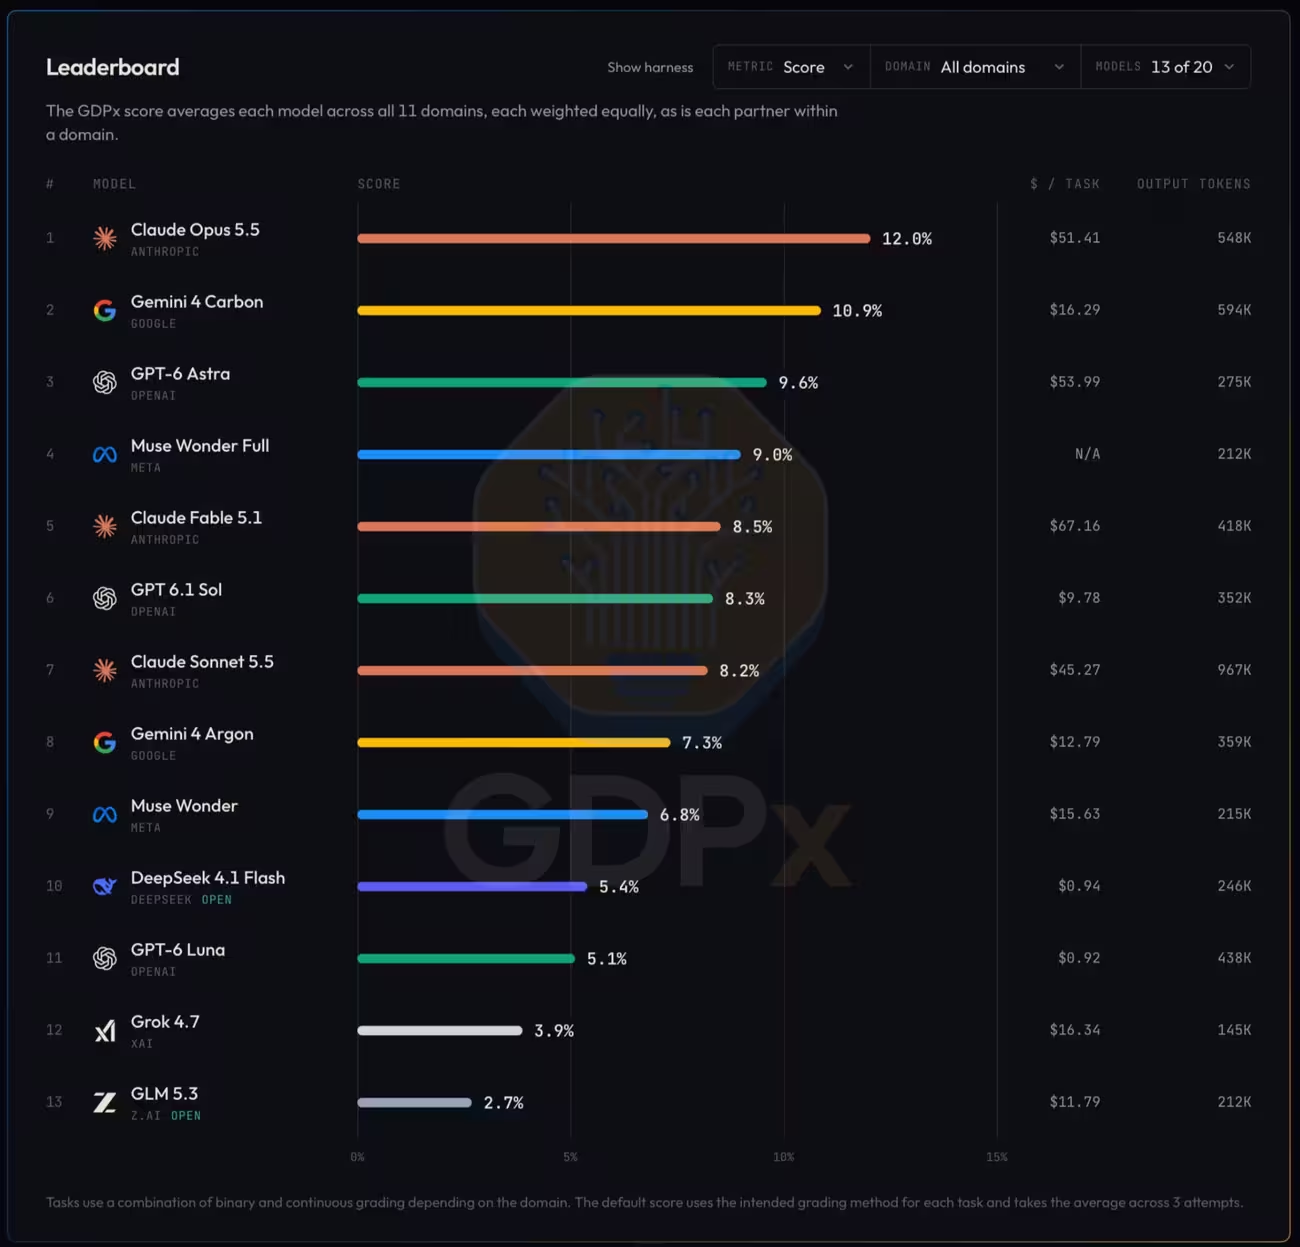
Googles Gemini 4 Carbon sänker kostnaden per uppgift till strax över 16 dollar – mindre än en tredjedel av Anthropics Claude Opus 5.5, som enligt SemiAnalysis GDPx-benchmark kostar omkring 51 dollar per uppgift.
I GDPx-topplistan ligger Opus 5.5 etta, med Gemini 4 Carbon tätt bakom i råpoäng. Gemini 4 Carbon når inte förstaplatsen, men kombinerar prestanda nära marknadsledarens med en betydligt lägre kostnad per uppgift. Det ger Googles nya modell ett tydligt värdeförsprång.
GDPx jämför ledande modeller från Google, OpenAI, Anthropic och Meta genom att väga samman modellpoäng och kostnad per uppgift. Metoden omfattar 206 uppgifter inom finans, materialvetenskap, cybersäkerhet, mjukvaruteknik, juridik och biologi. Resultaten är därmed inte begränsade till generell textgenerering eller vanliga frågor.
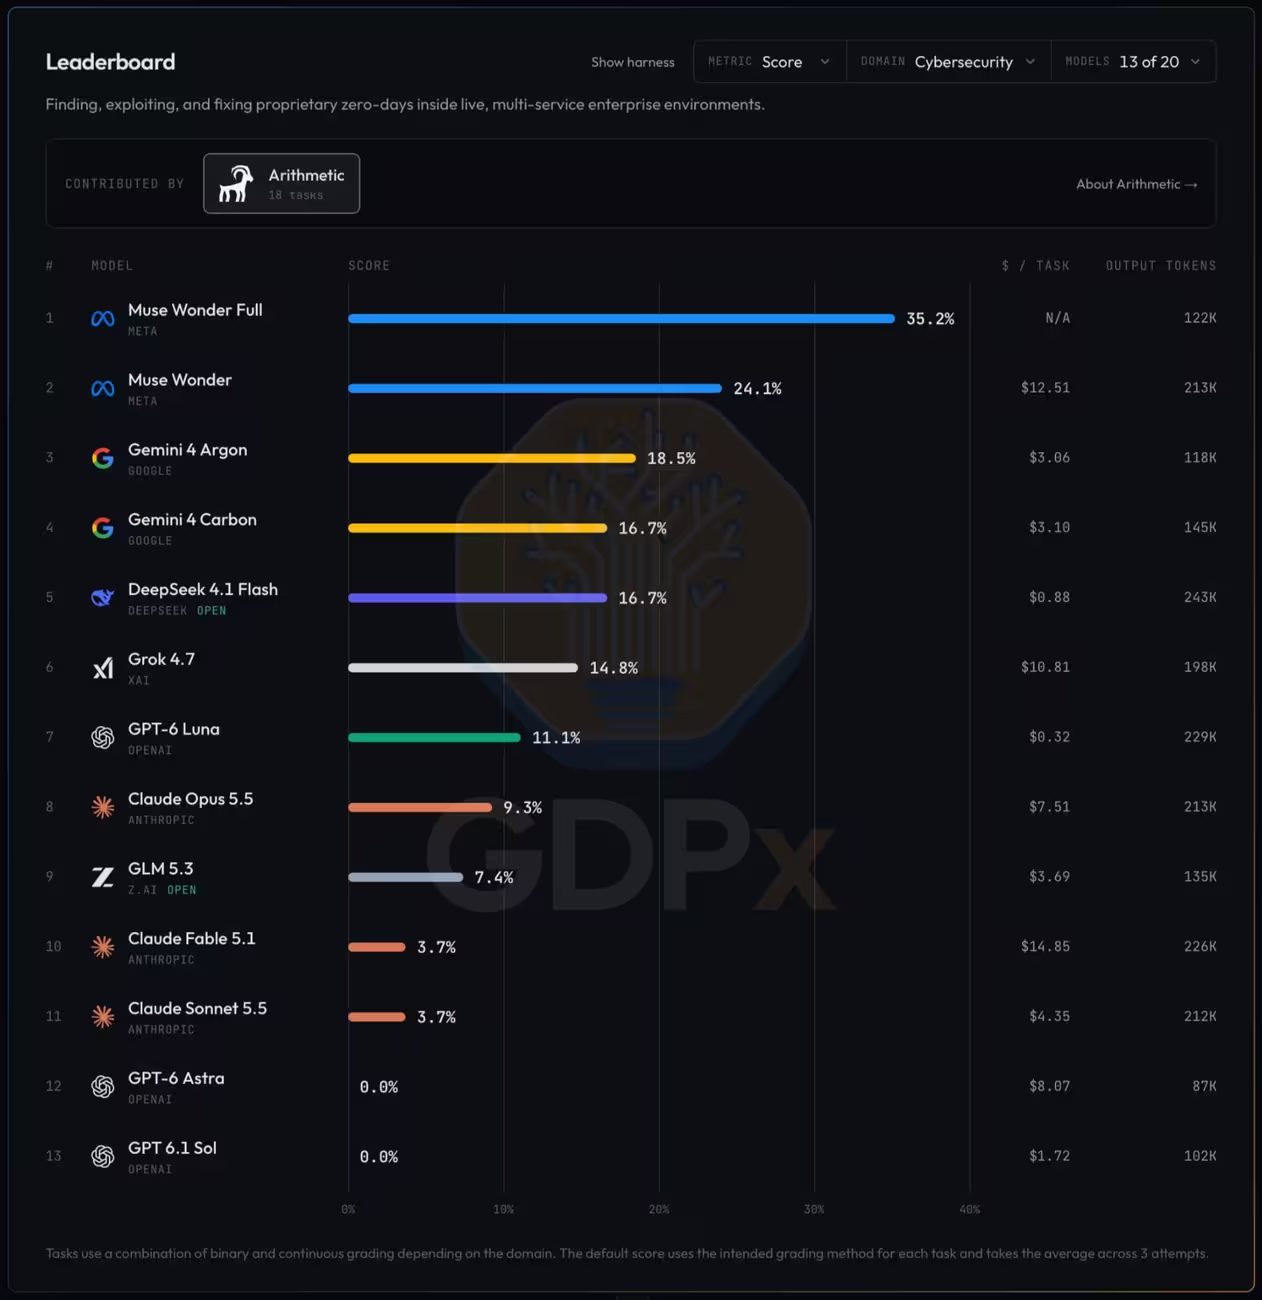
I den fullständiga GDPx-rankningen har Opus 5.5 högst totalpoäng, medan Gemini 4 Carbon följer med ett relativt litet poängavstånd. Kostnadsskillnaden är däremot betydligt större: SemiAnalysis rapporterar cirka 51 dollar per uppgift för Opus 5.5, jämfört med strax över 16 dollar för Gemini 4 Carbon. OpenAIs GPT-6 Astra ligger därefter i tabellen, men fick lägre poäng än Gemini 4 Carbon och hade en högre genomsnittskostnad – omkring 54 dollar per uppgift enligt rapporten.
Jämförelsen mellan de tre modellerna visar en tydlig skillnad mellan prestandaledaren och värdeledaren: Opus 5.5 leder i råpoäng, Gemini 4 Carbon närmar sig den prestandan till betydligt lägre kostnad, medan GPT-6 Astra hamnar efter båda och samtidigt kostar mer per uppgift.
Justerad rankning och säkerhetsfilter
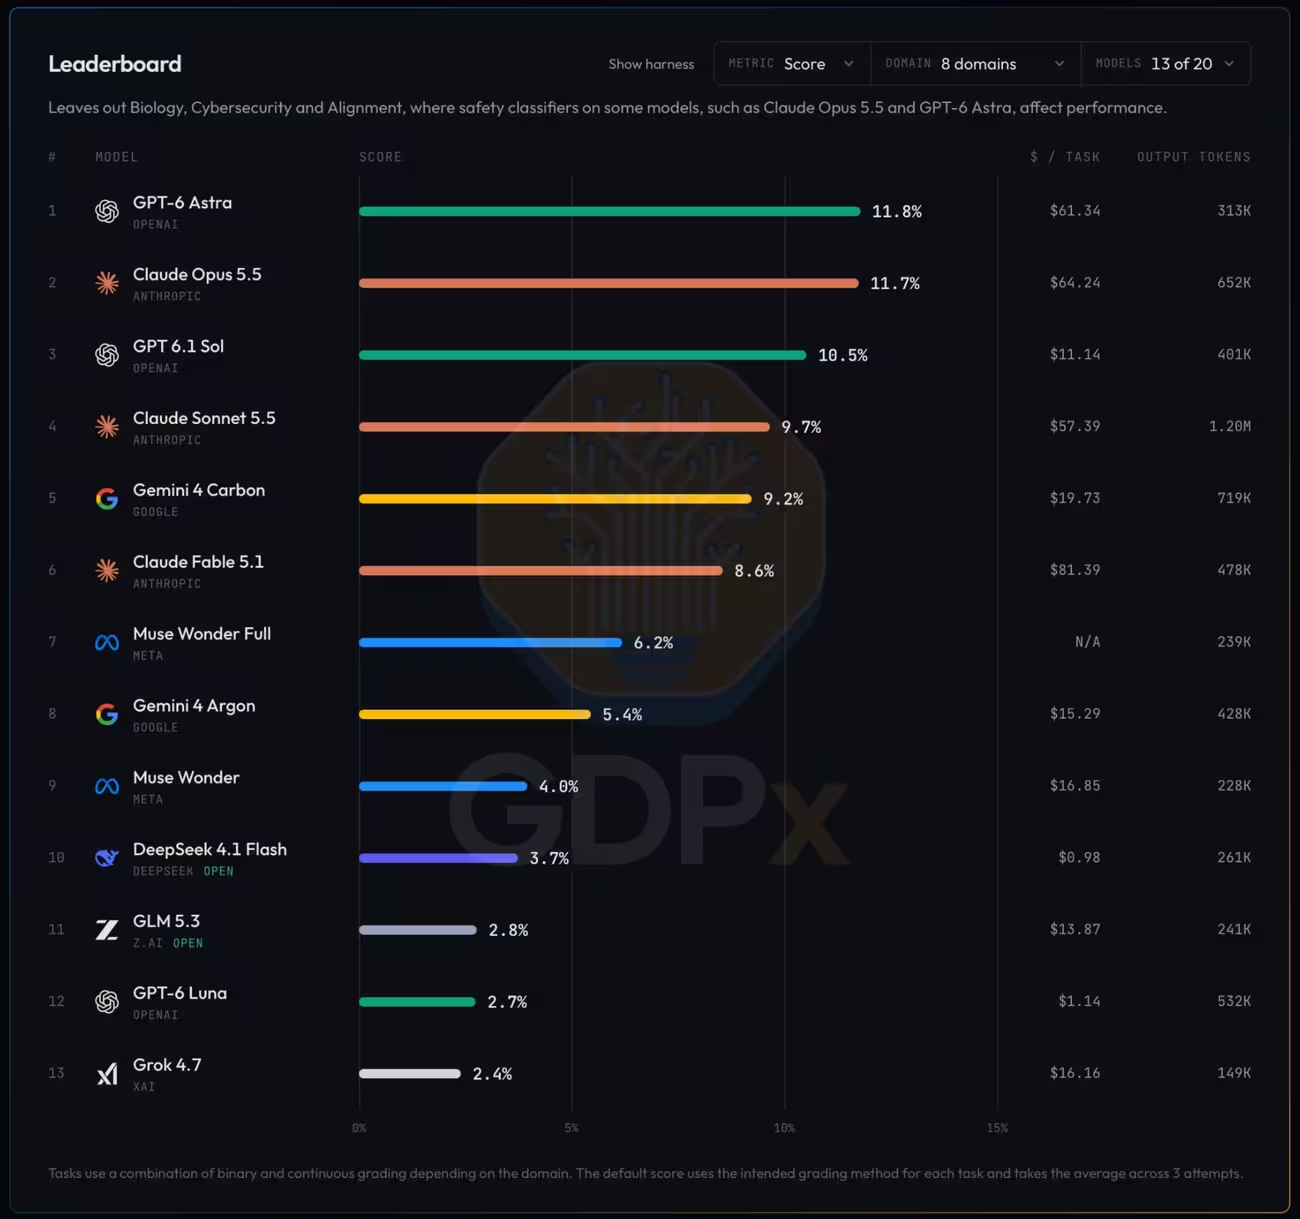
SemiAnalysis publicerade också en justerad rankning där uppgifter inom cybersäkerhet, biologi och alignment exkluderades. När dessa tre områden togs bort ändrades toppositionerna, och GPT-6 Astra hamnade etta. GPT 6.1 Sol och Opus 5.5 placerade sig också före Gemini 4 Carbon i den justerade listan. Forskarna uppgav att denna ranking bättre överensstämmer med deras subjektiva intryck av modellernas förmågor.
Rapporten konstaterar att säkerhetsspärrar i modeller som Claude och vissa GPT-varianter kan hindra dem från att slutföra vissa uppgifter inom cybersäkerhet, biologi eller alignment. Dessa skydd kan påverka de råa GDPx-poängen, vilket innebär att en modells resultat ibland speglar både dess tekniska förmåga och i vilken grad den tillåts svara på känsliga förfrågningar.
Googles tidigare frontiermodell, Gemini 4 Argon, hamnade på åttonde plats i både den fullständiga och den justerade rankningen. Den placerade sig över Metas Muse Wonder och under Wonder Full. Argons kostnad per uppgift i GDPx var bara något lägre än för Gemini 4 Carbon. Den lilla kostnadsskillnaden, i kombination med Carbons högre placering, tyder på en bättre balans mellan poäng och kostnad för Googles nyare modell.
Om endast cybersäkerhetsuppgifterna granskas förändras hierarkin: båda Google-modellerna presterade bättre än OpenAI och Anthropic på området, men hamnade efter Metas Muse-familj. Enligt GDPx är Muse-familjen den klart starkaste aktören inom cybersäkerhet. SemiAnalysis tillägger att de rapporterade kostnadsskillnaderna kan få verklig ekonomisk betydelse vid storskaliga, återkommande tester och företagsimplementeringar.
"Som teknikreporter skriver jag om digital kultur, sociala medier och människans relation till maskiner. Jag gillar när tekniken blir personlig."
Diskussion
Lämna en kommentar
Kommentarer
Inga kommentarer ännu. Bli den första.