Google har presenterat Gemini 4 Carbon, en högpresterande AI-modell för kodning, långvariga agentuppgifter och cybersäkerhet. Google beskriver Carbon som sin mest kraftfulla modell hittills, men den är ännu inte tillgänglig för allmänheten. Den tidiga åtkomsten är begränsad till en liten grupp säkerhetsspecialister.
Långvariga agentarbetsflöden och mjukvaruutveckling
Carbon är utvecklad för att hantera agentuppgifter som pågår i flera dagar, behålla framsteg i komplexa projekt och leverera användbara mjukvaruresultat. Google redovisar interna exempel där modellen arbetade vidare under flera dagar, tog sig förbi återvändsgränder och spårade grundorsakerna till subtila buggar i stora kodbaser och lågnivåsystem. Modellen är tänkt att dela upp problem i mindre steg, utvärdera resultatet av varje åtgärd, välja alternativa angreppssätt vid misslyckanden och leverera korrigeringar som tar hänsyn till projektets begränsningar.
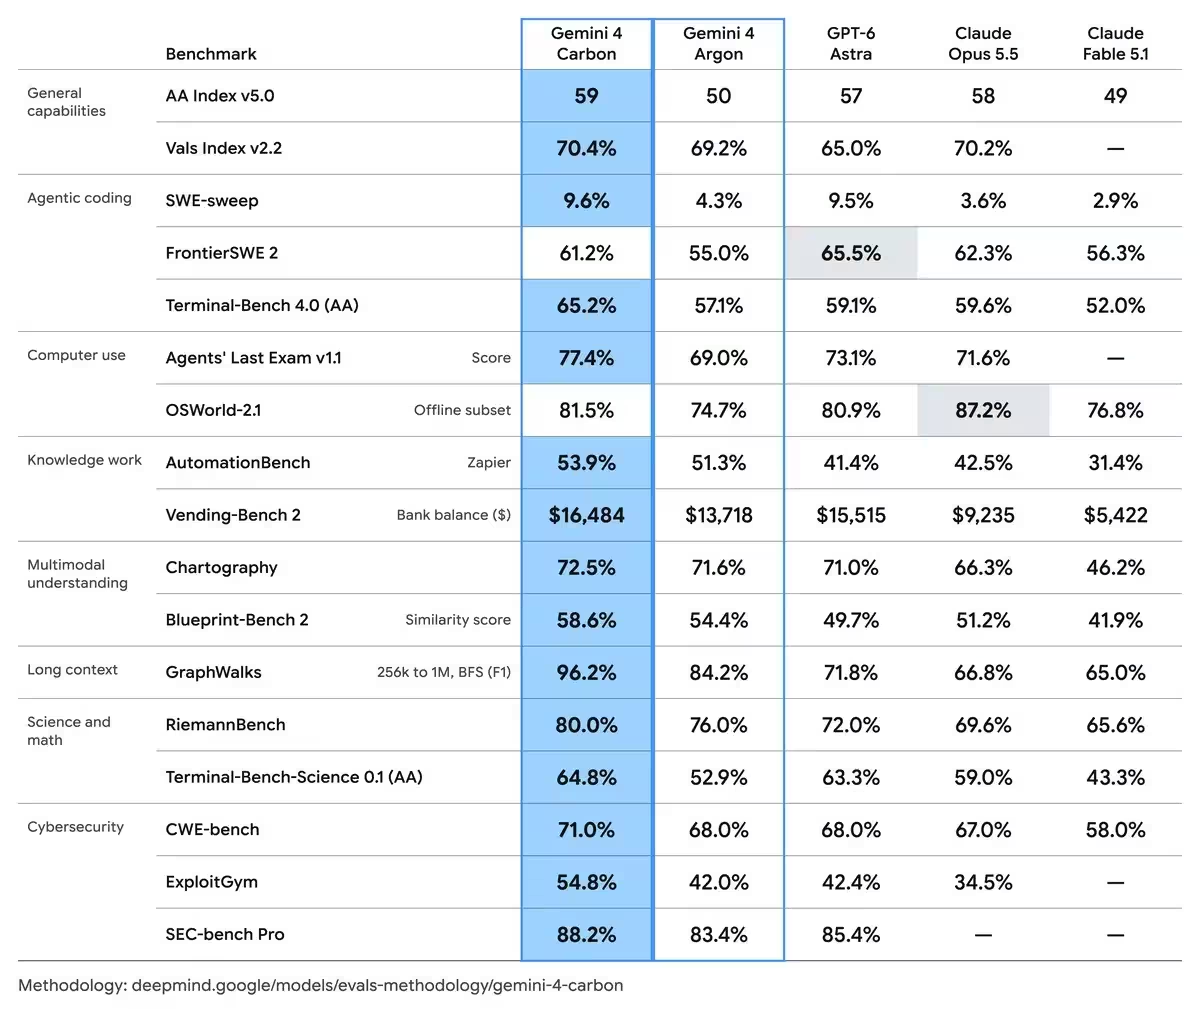
Enligt Google visar Carbon förbättringar inom vetenskapligt resonemang, multimodal förståelse, komplett webbutveckling och generering av användbara resultat. I Artificial Analysis Intelligence Index version 5.0 fick Gemini 4 Carbon 59 poäng och placerade sig etta. I webbutvecklingsarenan WebDev Arena ökade Carbon med 89 poäng till 1 769 poäng och hamnade på fjärde plats. Google påpekar att måttet bedömer resultatkvalitet genom direkta jämförelser och inte garanterar identisk prestanda i alla verkliga projekt.
Trestegsarbetsflöde för cybersäkerhet och benchmarkresultat
Google positionerar Carbon kring en trestegsprocess för cybersäkerhet: att hitta en verklig sårbarhet i en stor kodbas, bedöma om den går att utnyttja och ta fram en åtgärd som löser grundorsaken.
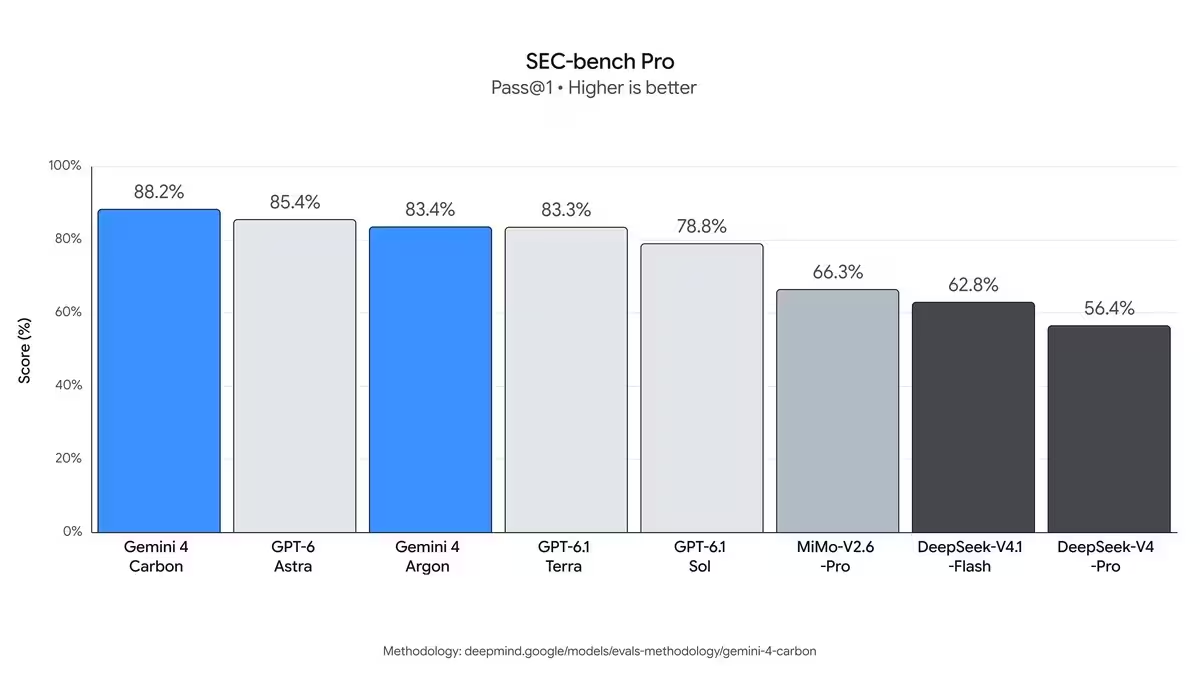
- Upptäckt: Carbon nådde 88,2 procent på SEC-bench Pro och identifierade automatiskt komplexa dolda fel i verklig mjukvara.
- Exploitvalidering: Carbon fick 54,8 procent på ExploitGym, som utvärderar om en modell kan bedöma utnyttjbarhet.
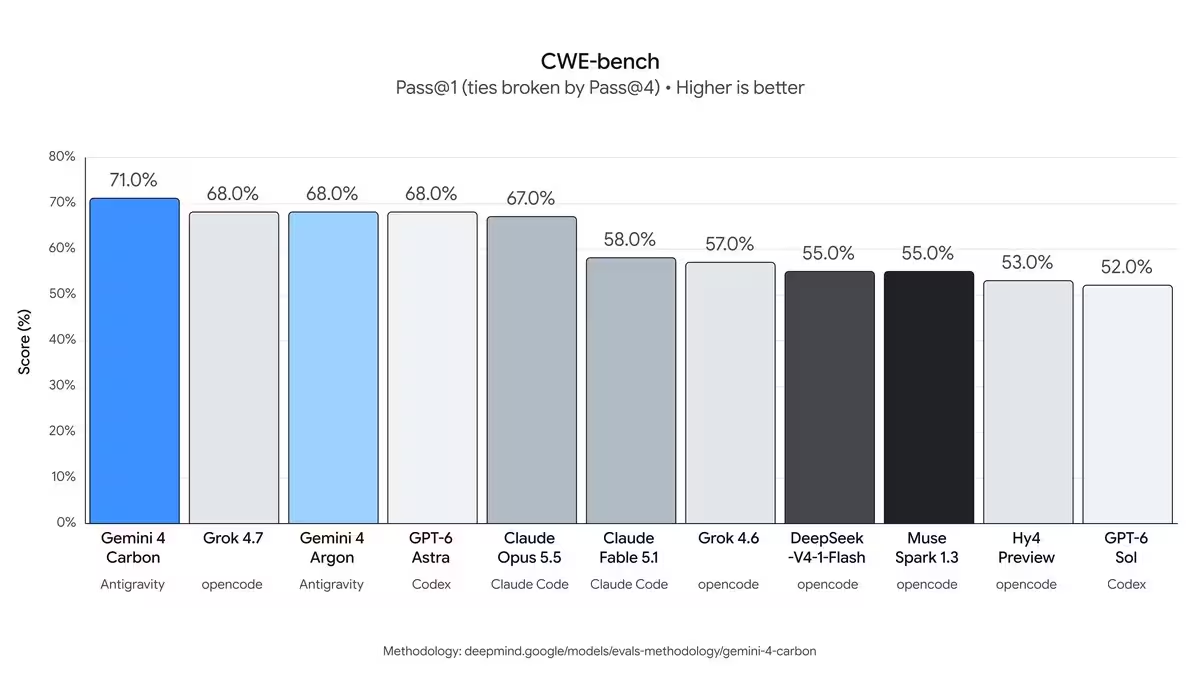
- Åtgärd av grundorsaken: Carbon uppnådde 71 procent på CWE-bench från Collinear genom att omvandla giltiga fynd till körbara patchar.
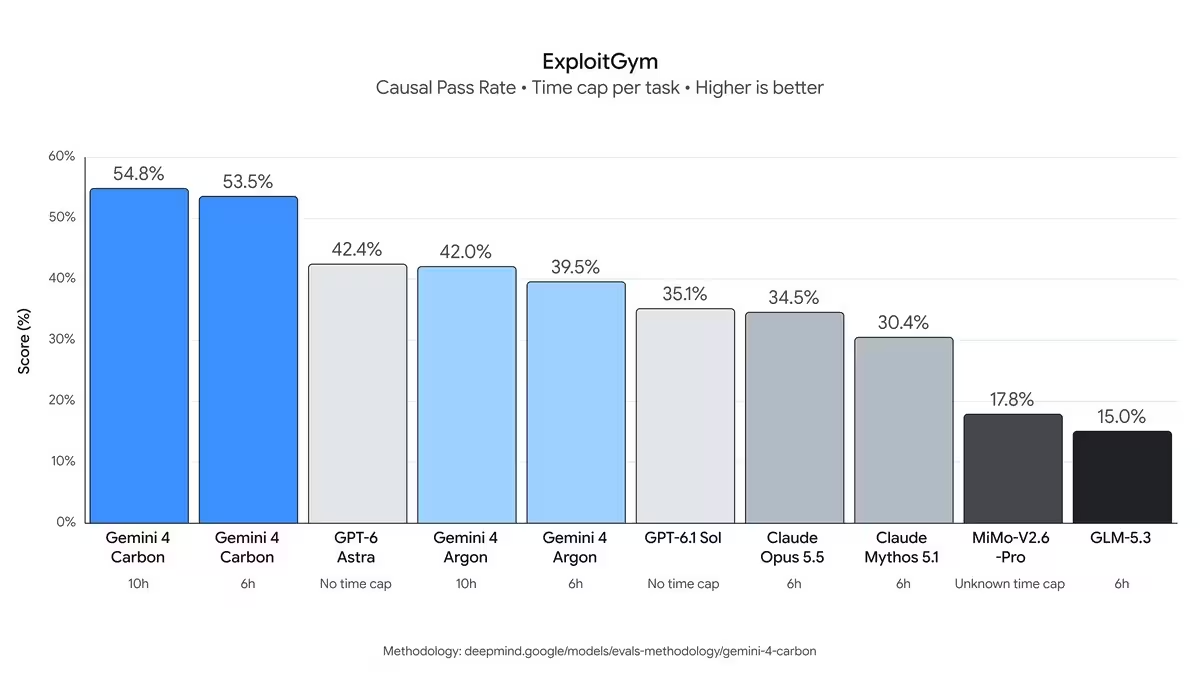
Dessa externa tester kördes utan säkerhetslager för att mäta modellens råa kapacitet. Google varnar för att produktionsimplementationer kommer att innehålla begränsningar och system för att upptäcka missbruk. I interna utvärderingar uppgavs Carbons träffsäkerhet för att producera säker kod vara mer än dubbelt så hög som Argons. Chrome-teamet rapporterade att Carbon producerade åtgärder av högre kvalitet i en takt som var mer än tio gånger högre än en stor, namnlös modell från ett annat laboratorium. Google angav varken konkurrenten eller den fullständiga testmetodiken. Säkerhetsplattformen Wiz noterade också Carbons fördel i webbpenetrationsmått som användes i deras Scan for Good-program.
Säkerhetsarkitektur, motstånd mot promptinjektioner och stegvis utrullning
Google använde samma flerskiktade försvarsarkitektur som för Argon, med en kombination av träningskontroller i modellen, realtidsskydd mot missbruk, motstånd mot promptinjektioner och övervakning av resonemangskedjor. Träningsmålen var utformade för att hindra modellen från att hitta genvägar som ger höga poäng utan att lösa det underliggande problemet.
I interna säkerhetsbenchmarks uppnådde Carbon en framgångsgrad på noll procent för fusk och en frekvens för fuskförsök på 0,4 procent i Terminal-Bench 4.0, samtidigt som den övergripande noggrannheten förbättrades. I interna kodningsmiljöer rapporterades omkring 80 procents färre allvarliga varningar om beteendemismatch. Tester visade också att obestyrkta påståenden sjönk till ungefär hälften av nivån för Argon. Carbon kan hämta relevanta källor innan den agerar och flagga inkonsekvenser i de data den hittar. Google rapporterade en minskning på 26 procent av beteenden utanför scope och 29 procent färre otillräckliga svar från tjänster.
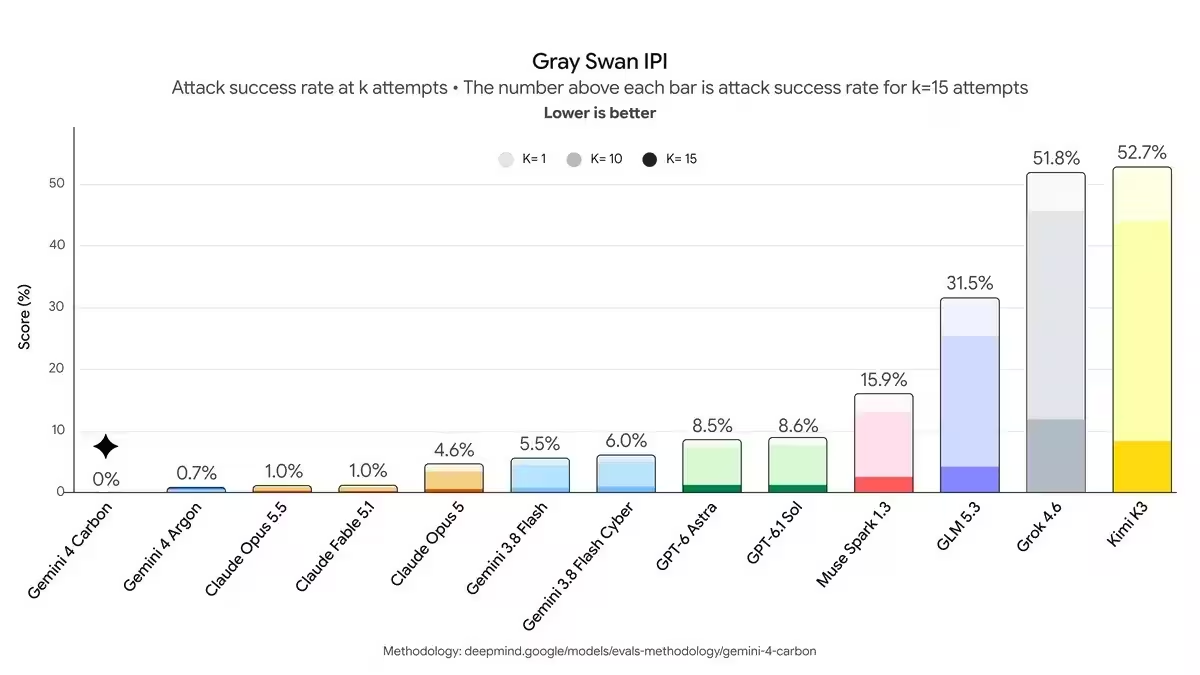
Carbon hade en framgångsgrad på noll procent mot indirekta promptinjektionsattacker i Gray Swan-benchmarken, jämfört med 0,7 procent för Argon i samma test. Google genomför en stegvis utrullning och deltar i den frivilliga amerikanska myndighetstestprocessen. En inledande grupp cybersäkerhetsförsvarare får tillgång, följt av en utvidgning till betrodda partner genom Fairwind-programmet. Feedback från testare ska användas för att förfina skydden. Google har inte angett någon tidplan för allmän tillgänglighet.
Prissättning och faktureringsdetaljer
Google uppgav att Carbon kommer att matcha Argon i introduktionsprissättning. Under den första perioden kostar bearbetning av en miljon inmatningstoken 2 USD, medan generering av en miljon utmatningstoken kostar 10 USD. Sparade inmatningstoken i cache debiteras med 95 procents rabatt jämfört med inmatningspriset. Efter introduktionsperioden höjs kostnaden för inmatningstoken till 4 USD per miljon och kostnaden för utmatningstoken till 20 USD per miljon. Google påpekade att den slutliga kostnaden för långvariga agentprojekt beror på mer än tokenpriset, bland annat antalet steg, verktygsanrop, kontextvolym och cacheanvändning.
"Som teknikreporter skriver jag om digital kultur, sociala medier och människans relation till maskiner. Jag gillar när tekniken blir personlig."
Diskussion
Lämna en kommentar
Kommentarer
Inga kommentarer ännu. Bli den första.