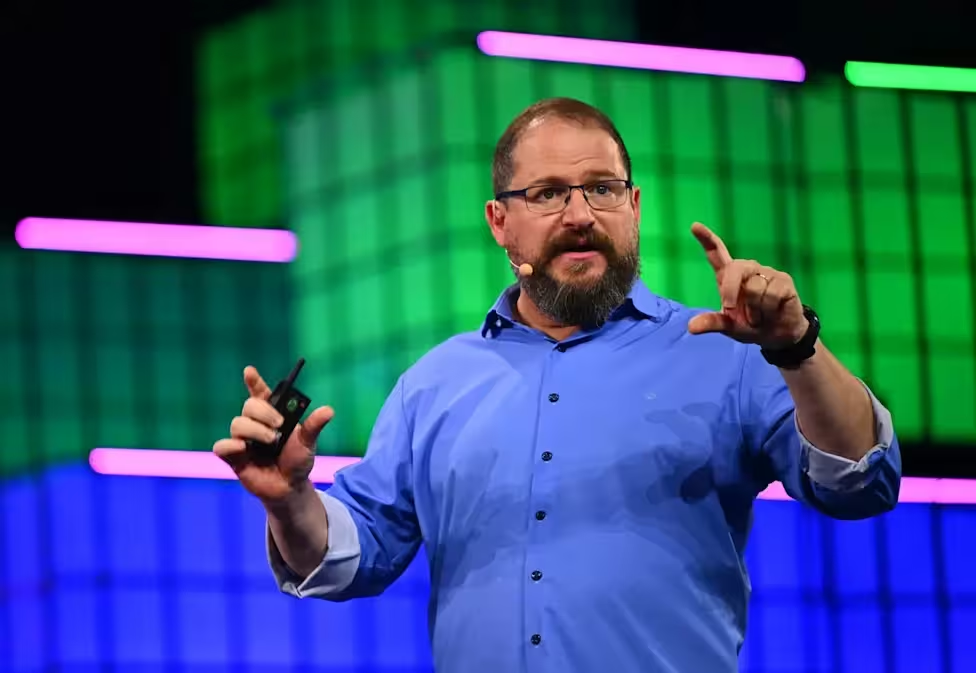
Qualcomms vd Cristiano Amon säger att vissa AI-företag redan utvecklar smartphones som kan köra språkmodeller med 100 miljarder parametrar kontinuerligt år 2028.
Amon gjorde uttalandet i en intervju med Fireside Alpha den 10 oktober 2026, men nämnde inga av de berörda företagen vid namn.
Att köra en modell med 100 miljarder parametrar på en telefon innebär stora minnesutmaningar. En 4-bitarskvantiserad 100B-modell kräver omkring 50 gigabyte RAM, medan en 2-bitarsvariant fortfarande skulle behöva cirka 25 gigabyte enbart för modellen – innan operativsystem, appar och kontextcache räknas in.
Qualcomm och andra lyfter fram tillgången till och kostnaden för DRAM som de största hindren. Företaget uppgav att branschen sannolikt inte kommer att gå över den vanliga gränsen på 16 gigabyte minne inom den närmaste tiden. Tillverkarna har dessutom begränsat modeller med mer RAM i ett pressat DRAM-marknadsläge, trots att Android-telefoner för omkring ett år sedan erbjöd upp till 24 GB LPDDR5X.
Kontinuerlig inferens med större modeller ökar också värmeutvecklingen och risken för termisk strypning. Det är fortfarande en praktisk begränsning, även om tillräcklig minneskapacitet skulle finnas.
Förändringar i chipsetpaketeringen, däribland Apples A20 Pro och Qualcomms Snapdragon 8 Elite Extreme Gen 6, löser vissa integrationsproblem men undanröjer inte minnesflaskhalsen.
Bland de tekniska lösningarna finns aggressiv kvantisering, som kan minska minnesbehovet kraftigt. 1-bitarsvarianter kan rymmas i DRAM, men enligt branschbedömningar försämras modellkvaliteten avsevärt vid kvantisering under 4 bitar, särskilt när det gäller resonemang.
En annan metod är Mixture of Experts med offloading av experter. Då är endast en delmängd av experterna aktiva i RAM för varje token, medan övriga lagras i flashminnet. Apple har undersökt möjligheten att köra modeller från inbyggd flashlagring, men UFS- och NVMe-lagring är fortfarande långsammare än DRAM och kan sänka inferenshastigheten.
Modelldestillering är för närvarande den mer kommersiellt gångbara vägen. Destillerade modeller med 20–30 miljarder parametrar kan efterlikna prestandan hos vissa 100B-modeller på enheten, samtidigt som kraven på minne och värme hålls på en hanterbar nivå.
Amon presenterade ingen teknisk färdplan och identifierade inga partners. Tillgången till DRAM, kostnaderna och de termiska begränsningarna är fortfarande de främsta hindren för att köra 100B-modeller lokalt på smartphones år 2028.
"Som teknikreporter skriver jag om digital kultur, sociala medier och människans relation till maskiner. Jag gillar när tekniken blir personlig."
Diskussion
Lämna en kommentar
Kommentarer
Inga kommentarer ännu. Bli den första.