
Föreställ dig att du går live och, utan större uppmärksamhet, blir din röst och bild en del av en träningsuppsättning för Amazons nästa AI-våg. Det är precis den förändring Twitch tillkännagav: strömningsinnehåll kommer nu att kunna användas för att träna Amazons modeller om inte skaparna väljer att avstå.
Tvister om integriteten kring rå träningsdata är inte längre teoretiska. Utvecklare och juridiska team har brottats i åratal om vilka källor stora modeller lär sig från. Vissa företag undviker kontroversen genom att bara använda material från sina egna plattformar. Meta, till exempel, kan hämta innehåll från Facebook- och Instagram-sidor som är offentliga. Privata profiler förblir dock otillgängliga, åtminstone i princip.
Det som skiljer Twitch åt är omfattningen och intimiteten. Strömmar är långa, multimodala och röriga: timmar av röst, ansiktskamera, livechatt, spelmoment och spontana ögonblick som du inte hittar i redigerade arkiv. För AI-forskare är den röran en guldgruva för att lära modeller att tala, reagera och bete sig mer som verkliga människor. För skapare känns det som att någon rotar i en digital vind.
Dina tidigare sändningar kan lära nästa generations AI att tala, se ut och reagera.
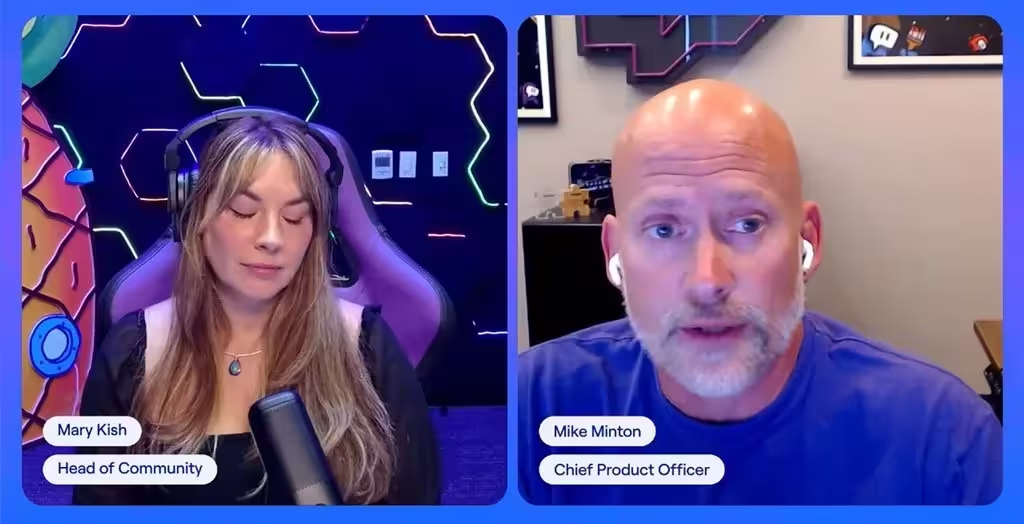
Amazon säger att skapare kan välja att inte delta. Men valet är standardmässigt förvalt som deltagande. Många streamers upptäcker ändringen först efter att en policyuppdatering har rullat förbi eller när en upprörd chatt exploderar under en bolagssändning. Den explosionen har redan inträffat: en nyligen genomförd Twitch-sändning med plattformsansvariga fick tusentals arga svar i chatten, en tydlig signal om hur laddat detta känns för gemenskapen.
Det finns en bredare oro att detta inte är en engångsföreteelse. Streamers undrar om deras gamla arkiv togs med långt innan något tillkännagivande. Tekniska jättar brukar förneka godtycklig skrapning, men språk- och multimodala modeller har uppenbarligen tränats på stora delar av webben (bilder, böcker, videor) och nu verkar även liveströmmar omfattas.
Så vad bör skapare göra? Kontrollera dina inställningar. Läs det finstilta. Bestäm om du vill att ditt innehåll ska bli råmaterial för generativa system. Be också plattformarna om tydligare, proaktiva samtyckesflöden istället för begravda reglage. Debatten om vem som äger uppmärksamheten online är långt ifrån över, men för alla som går live blir frågan plötsligt mycket personlig.
"Jag bevakar trender inom AI och maskininlärning. Det fascinerar mig hur tekniken lär sig tänka – och hur vi människor förändras tillsammans med den."
Diskussion
Lämna en kommentar
Kommentarer
Inga kommentarer ännu. Bli den första.