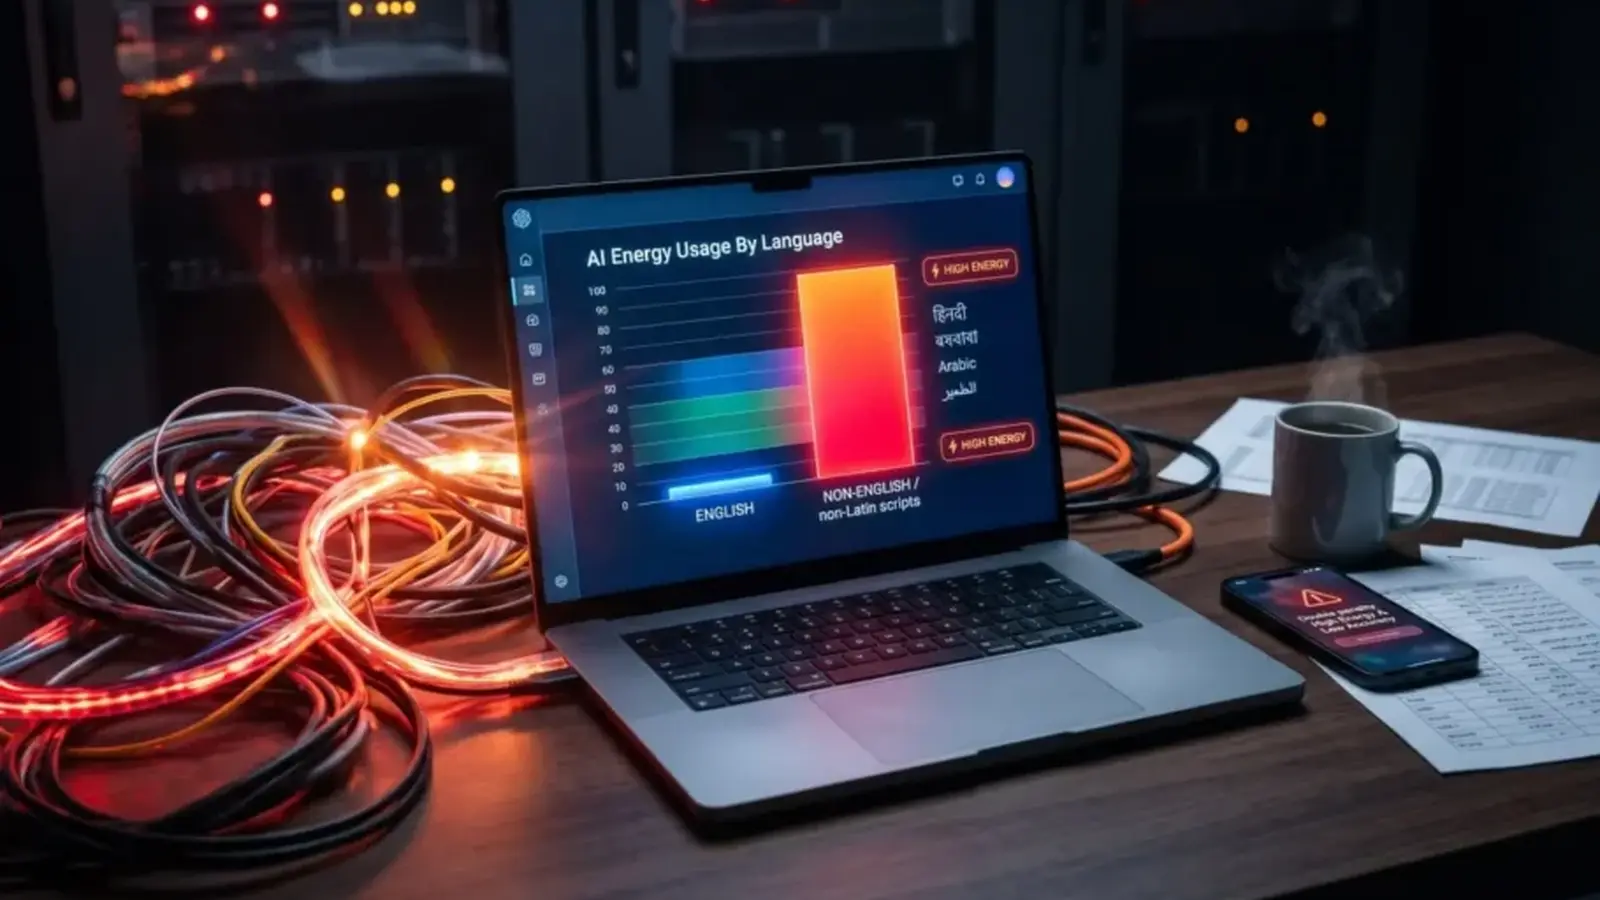
En ny studie från University of Michigan visar att generativa AI-modeller förbrukar betydligt mer energi när de genererar text på andra språk än engelska – mellan 1,4 och 180 gånger mer. Dessutom kan modellerna ge mindre träffsäkra resultat på dessa språk. Forskarna rapporterar att AI-modeller använder mellan 1,4 och 180 gånger mer energi för att generera text på andra språk än engelska.
Studiens resultat och omfattning
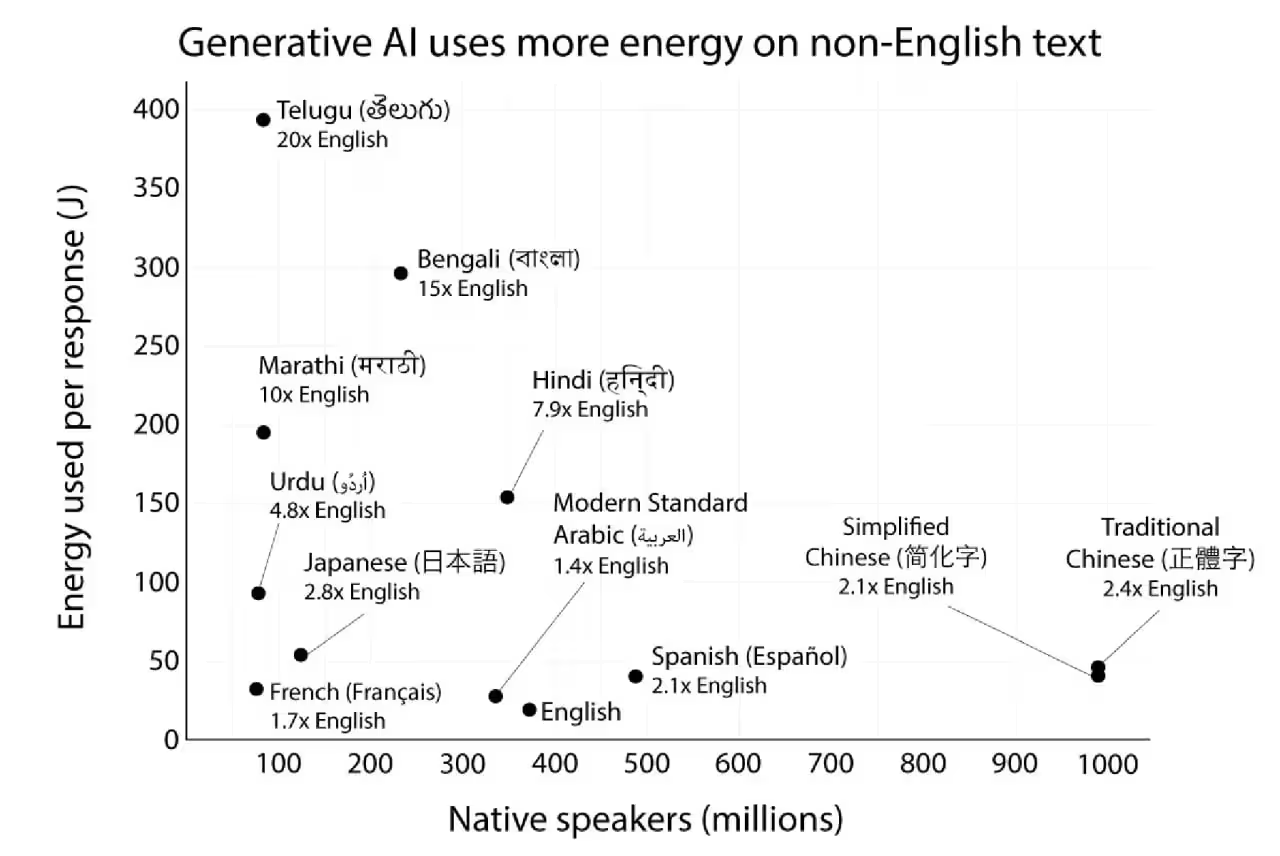
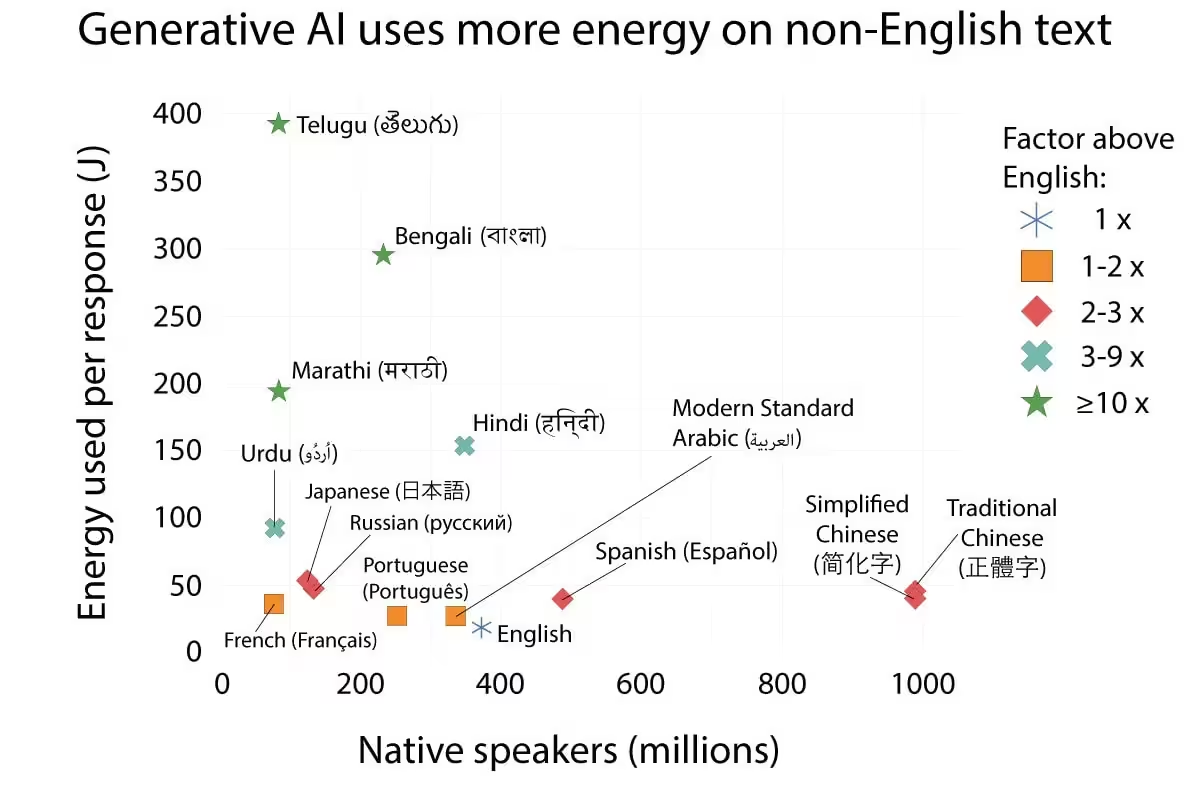
Forskningen, som presenterades vid EMNLP-konferensen, mätte energianvändningen vid textgenerering på flera språk. De största skillnaderna syntes i språk som inte använder det latinska alfabetet och som har mindre digitalt träningsmaterial. I genomsnitt kräver modellerna 1,4 till 180 gånger mer energi för icke-engelsk text än för engelska. Västeuropeiska språk var som mest omkring dubbelt så energikrävande som engelska, medan hindi och bengali krävde 7,9 respektive 15,3 gånger så mycket energi. Författarna uppskattar att omkring 5,2 miljarder människor behöver mer än dubbelt så mycket energi för att generera text på sitt förstaspråk jämfört med engelsktalande.
Naihao Deng, doktorand i datavetenskap och teknik vid University of Michigan och artikelns förstaförfattare, säger att språk som förbrukar mer energi också tenderar att få lägre modellnoggrannhet. Han beskriver effekten som en "dubbel bestraffning" som kan begränsa tillgången för användare genom högre kostnader och minska företagens incitament att stödja vissa språk.
Metoder, modeller och mätningar
För att kvantifiera skillnaden utvärderade forskargruppen tre öppna modeller och mätte energiförbrukningen med ett särskilt ramverk. De testade modellerna var:
- Qwen 3 (Alibaba)
- Gemma 3 (Google)
- Llama 3.1 (Meta)
Forskarna använde datasetet Belebele, som bedömer modellernas språkförståelse på 122 språk, och mätverktyget ML.Energy. De testade flervalsfrågor, matematikproblem och öppna textuppmaningar. Resultaten visade att samtliga tre modeller i genomsnitt förbrukade mindre energi för engelska uppmaningar. Skillnaderna kvarstod även för större modellstorlekar och olika processorer.
Orsaker och teknisk förklaring
Den främsta tekniska orsaken är tokenisering. Tokens är de grundläggande dataenheter som modellerna bearbetar, och text omvandlas till tokens före beräkningen. Språk som hindi och nepali, där tecken ändrar form eller kombineras med diakritiska tecken, genererar betydligt fler tokens för samma semantiska innehåll. Fler tokens ökar minnesanvändningen, vilket tvingar modellerna att bearbeta dem i mindre batchar. Mindre batchar ökar energiförbrukningen per token och minskar genomströmningen. Eftersom många leverantörer tar betalt utifrån antalet tokens kan användare som inte skriver på engelska också få högre direkta kostnader.
Konsekvenser och föreslagna åtgärder
Studien pekar på en möjlig källa till global digital ojämlikhet: användare av många icke-latinska språk och språk med begränsade resurser kan behöva betala mer i energi och pengar, samtidigt som de får resultat av lägre kvalitet. För att minska obalansen rekommenderar forskarna att AI-företag optimerar sina tjänster för ett bredare urval av språk, exempelvis genom att styra förfrågningar till språkspecifika modeller eller översätta uppmaningar till engelska före bearbetning när det är lämpligt.
"Jag bevakar de senaste tekniknyheterna – från nya produkter till digitala trender. Mitt mål är att hjälpa läsarna förstå vad som händer just nu och varför det spelar roll."
Diskussion
Lämna en kommentar
Kommentarer
Inga kommentarer ännu. Bli den första.