
Föreställ dig ett framtida Google-datacenter där skräddarsydda AI-acceleratorer sitter sida vid sida med högpresterande AMD-kärnor. Märkligt? Kanske. Strategiskt? Absolut.
Marknadssusningar som återfanns i en SemiAnalysis-notis säger att Google samarbetar med AMD kring en av modellerna i sin tionde generation av TPU-familjen. Om det stämmer blir detta AMD:s första stora satsning i ett skräddarsytt AI-ASIC-projekt i den här skalan. Tanken är inte att överlämna hela TPU-blåtrycket till en chiptillverkare; det handlar om att integrera AMD:s IP och paketeringsexpertis i en hybridarkitektur som kan hantera en ny klass arbetsbelastningar.
Detta skulle markera AMD:s första stora partnerskap för specialbyggda AI-chip med Google.
Varför ta in AMD i leken nu? Svaret ligger i hur AI utvecklas. Moderna modeller kräver i allt högre grad mer än ren matrisberäkning. De behöver mångsidig allmän processorprestanda parallellt med acceleratorer, tänk förstärkningsinlärningsloopar, orkestrering på operativsystemsnivå och komplexa resonemangsuppgifter som inte helt kan avlastas till tensormotorer. Att placera AMD:s CPU-kärnor direkt på TPU-paketet skulle ge Google flexibiliteten att köra dessa blandade arbetsbelastningar med lägre latens och tätare integration.
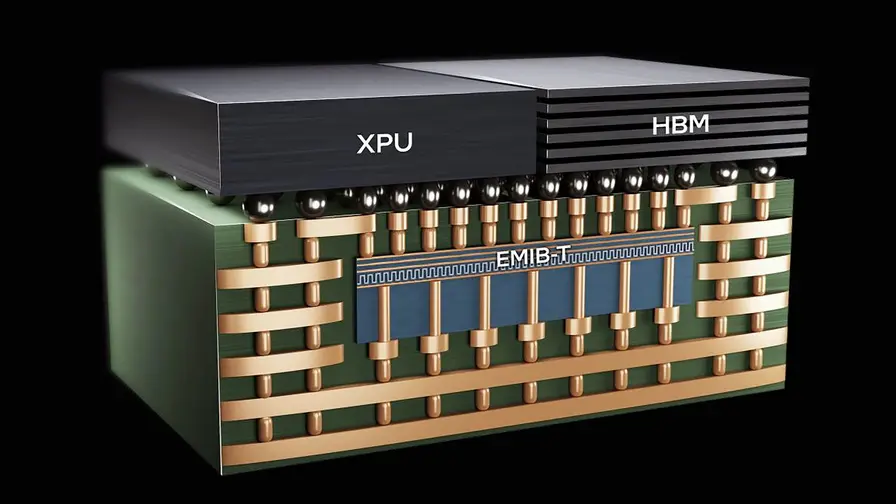
AMDs styrkor är tydliga: avancerade paketeringstekniker som SoIC, en omfattande patentportfölj och mogna CPU-arkitekturer. Dessa tillgångar spelar roll när man staplar die, leder högbandbredds länkar och försöker pressa ut varje uns prestanda och energieffektivitet ur ett enda paket. Google designar redan mycket av sin acceleratorarkitektur och har historiskt samarbetat med Broadcom för tidigare TPU-generationer. Den här gången ser det dock ut som ett äktenskap mellan specialbyggda acceleratorer och en tungviktig CPU-leverantör.

Förvänta dig inte att AMD ska omplaceras till huvudarkitekt för TPU-inferens eller träningsvarianter. Ett klokare antagande är att Google behöver programmerbara logikblock, skräddarsydda sammankopplingar och paketeringsexpertis som en större CPU-leverantör kan leverera, saker som går bortom ren acceleratorutformning. I praktiken innebär det hybridchips där specialiserade tensormotorer samexisterar med allmänna kärnor som hanterar kontroll, schemaläggning och de röriga delarna av verkliga AI-arbetsbelastningar.
Det finns föregångare i Googles serverutveckling. Nyare TPU 8i-distributioner parar acceleratorer med Googles egen Axion-processor, medan äldre uppsättningar förlitade sig på Intel Xeon-CPU:er som delades mellan flera acceleratorer. Trenden över generationer har gått mot mer lokal bearbetningskraft per accelerator, en indikation på varför det kan vara attraktivt att integrera AMD-kärnor.
För molnkunder är konsekvenserna praktiska: färre hopp mellan chips, bättre genomströmning för pipelines för förstärkningsinlärning och potentiellt nya distributionsmönster för latenskänsliga tjänster. För AMD är det en chans att visa paketering och kunnande inom heterogen integration i ett område som länge dominerats av team för skräddarsydda ASIC:er.
Hur som helst skulle detta partnerskap, om det slutförs, understryka en förändring i hur hyperscalare ser på specialiserad kisel: inte bara snabbare matrisberäkningar, utan tätare ekosystem av olika beräkningsenheter som arbetar tillsammans. Håll ögonen öppna; nästa decennium för moln-AI kan byggas mindre som en ensam motor och mer som en orkester som stämmer upp.
"Som teknikreporter skriver jag om digital kultur, sociala medier och människans relation till maskiner. Jag gillar när tekniken blir personlig."
Diskussion
Lämna en kommentar
Kommentarer
Inga kommentarer ännu. Bli den första.