
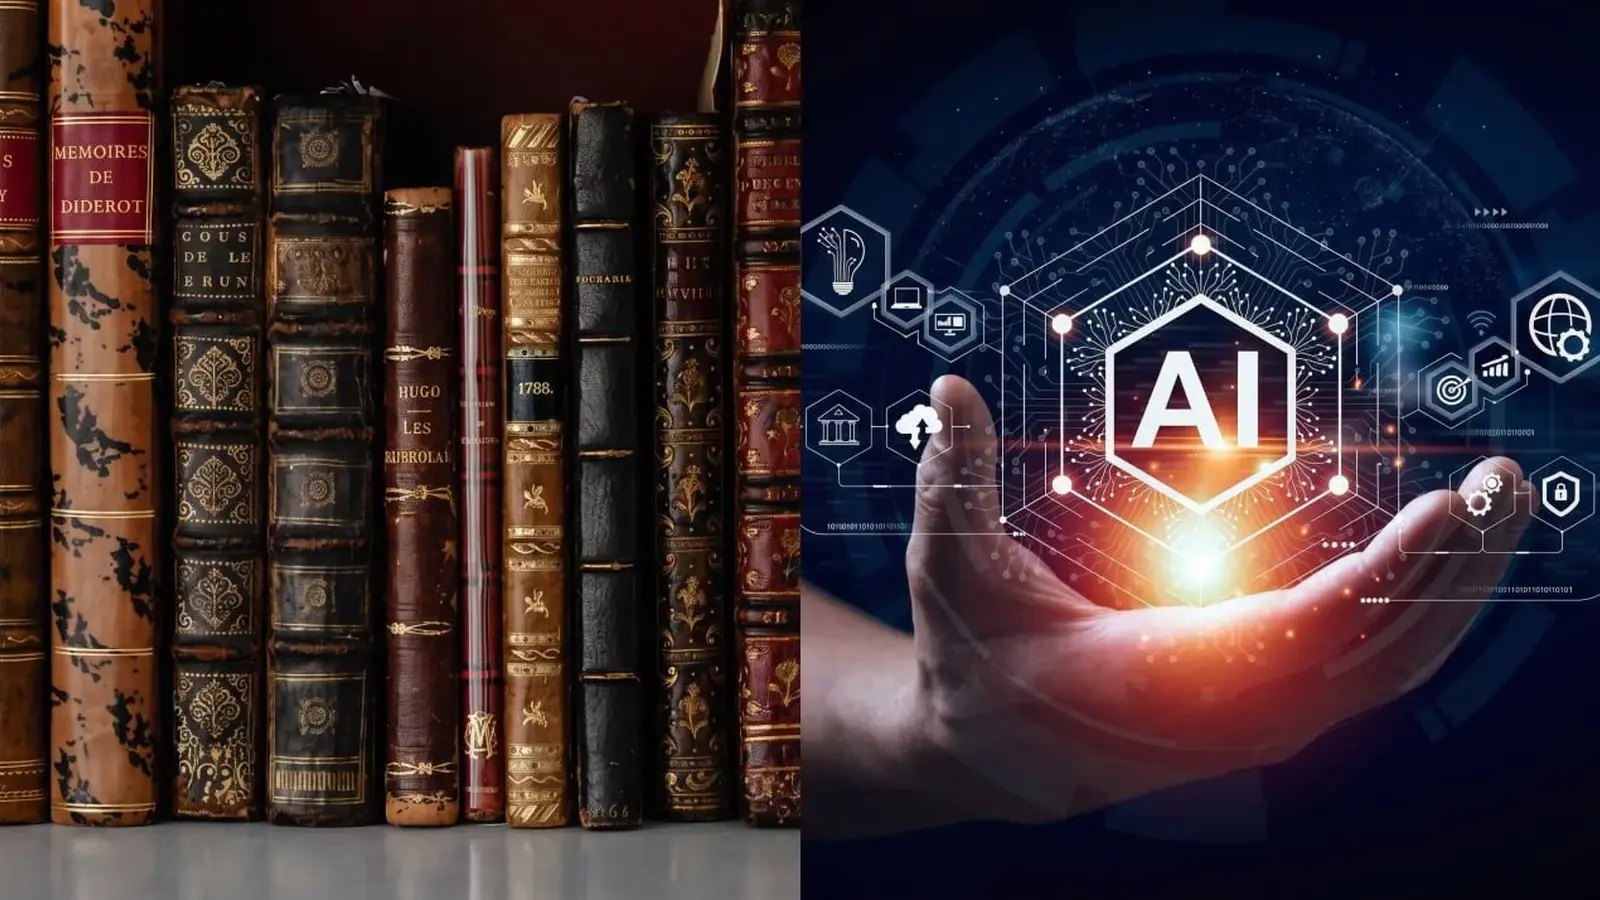
De anländer till lager i omärkta lastbilar. Långa pallar. Kartonglådor stämplade med ISBN-etiketter. Tyst arbete. Snabbare än bevarande. Scenen låter som en logistisk operation, men lasten är litteratur: miljoner tryckta böcker på väg till industriella skannrar som river dem sida för sida.
Det du läser om är inte en konspirationsteori. Rättsliga handlingar och visselblåsarrapporter visar att flera AI-företag har tagit till destruktiva skanningsmetoder för att digitalisera tryckta texter i stor skala. Istället för varsam, hyllbevarande fångst tas bokryggarna bort och sidor matas in i högfarts industriella skannrar. Avvägningen är brutalt enkel: snabbhet och lägre kostnad kontra det tryckta verkets fysiska överlevnad.
En avslöjande tråd löper genom handlingarna. Tidigare anställda som arbetade med Google Books och senare projekt som Anthropics interna insatser, i rättegångarna kallat Project Panama, har vittnat att leverantörer som erbjöd både skonsam overheadskanning och den snabbare destruktiva tjänsten användes. För AI-utvecklare är beslutet pragmatiskt. Destruktiv skanning kostar mindre och ökar genomströmningen med flera storleksordningar.

Anthropic, till exempel, anklagas för att ha spenderat miljoner för att extrahera träningsdata från tryckta böcker köpta via återförsäljare som Better World Books och sedan förstöra dessa exemplar efter skanning. Även om en domare nyligen fastslog att användning av upphovsrättsskyddade verk för AI-träning i vissa sammanhang kan falla under skälig användning, friade inte den domen Anthropic från straffåtgärder när privata arkiv visade sig innehålla miljontals digitaliserade kopior tagna utan korrekt tillstånd från författare eller förlag, en handling som enligt uppgift utlöst böter på upp till 1,5 miljarder dollar.
Förlagen har inte suttit stilla. Koalitioner av förlag har väckt talan och hävdat att andra teknikjättar använde upphovsrättsskyddade titlar utan tillstånd för att träna stora språkmodeller. Den rättsliga striden handlar om både rättigheter och ersättningar, men en större kulturell fråga svävar över rättssalen: bör privata företag tillåtas att förvandla offentliga och privata biblioteksbestånd till proprietära data och sedan makulera originalen?
Så varför köper teknikföretag upp begagnade böcker per pall? Det korta svaret är träningsdata. Högkvalitativa, mänskligt skrivna texter förblir bland de mest värdefulla indata för avancerade språkmodeller. Webben är redan fylld av lågkvalitativt AI-genererat innehåll, föraktfullt kallat AI-skräp, som förorenar signalen. För att bygga modeller som levererar sammanhängande, korrekt prosa vill utvecklare ha autentiska källor: välredigerad skönlitteratur, rigorös facklitteratur och obskyra akademiska monografier som inte finns i genomsökta webbkorpusar.
Här kommer marknader som ISBNdb in i bilden, en online-databas som listar mer än 111 miljoner titlar. Beställningar via sådana plattformar varierar kraftigt, allt från tusen exemplar till en enskild affär på en miljon. Säljare som tidigare skickade några tiotal böcker i veckan rapporterar nu femfaldiga ökningar, ibland mer. Köpare betalar ofta stora summor och visar litet intresse för ämne eller författare; om en volym har ett ISBN är den en kandidat.

Det finns praktiska och etiska dimensioner i denna förändring. Å ena sidan kan digitalisering av sällsynta texter förbättra upptäckbarheten och säkerställa att innehåll överlever fysisk nedbrytning. Å andra sidan berövar den storskaliga borttagningen av tryckta verk från cirkulationen, följd av deras förstörelse, bibliotek, begagnatbokmarknader och framtida forskare tillgång. Blir sällsynta eller historiskt betydelsefulla utgåvor sållade bort innan förstörelsen? Uppgifterna är oklara. Det som är tydligt är att skannade texter ofta hamnar i privata databaser, tillgängliga endast för de företag som betalat för dem.
Föreställ dig en generation som behöver verifiera ett citat eller studera en arkivanteckning, men där nyckelvolymer inte längre finns i fysisk form och de digitaliserade kopiorna ligger bakom företagsmurar. Avvägningarna sträcker sig bortom äganderättsfrågor. De rör kulturförvaltning, tillgång till kunskap och vem som kontrollerar de råmaterial som driver framväxande AI.
Att förstöra böcker för att träna morgondagens intelligens väcker en svår fråga: är teknologisk utveckling värd den permanenta förlusten av delar av vårt pappersbaserade arv?
Beslutsfattare, bibliotekarier och teknologer måste avgöra om man ska acceptera privat hamstring av digitaliserad litteratur, föreskriva offentlig tillgång eller reglera metoderna som används för att fånga tryckta verk. Debatten har bara börjat, men hyllorna fortsätter flyttas och maskinerna fortsätter att surra. Vem ska tala för böckerna?
"Jag bevakar trender inom AI och maskininlärning. Det fascinerar mig hur tekniken lär sig tänka – och hur vi människor förändras tillsammans med den."
Diskussion
Lämna en kommentar
Kommentarer
Inga kommentarer ännu. Bli den första.