
Minne håller tyst på att bli flaskhalsen i jakten på snabbare AI-inferens. SK hynix flyttade precis gränsen genom att leverera provexemplar av sitt nya HBM4E till partners och öka pressen på minnesbandbredden i acceleratorarkitektur.
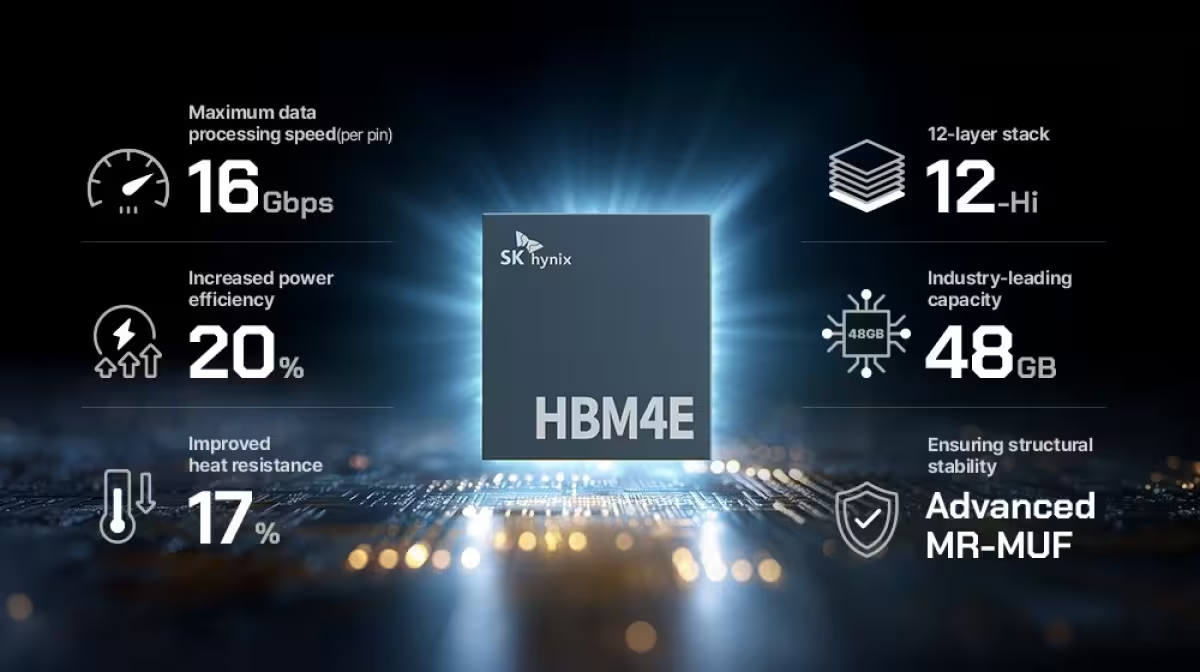
Kort sagt: det är snabbare. SK hynix HBM4E når 16 Gbps per pin, upp från 10 Gbps i den tidigare HBM4-specifikationen. Samsung, som inte ville bli utan, började prova en 14 Gbps-design ungefär en månad tidigare, men SK hynix hopp är anmärkningsvärt eftersom prestandavinster ofta innebär smärtsamma avvägningar. Inte den här gången.
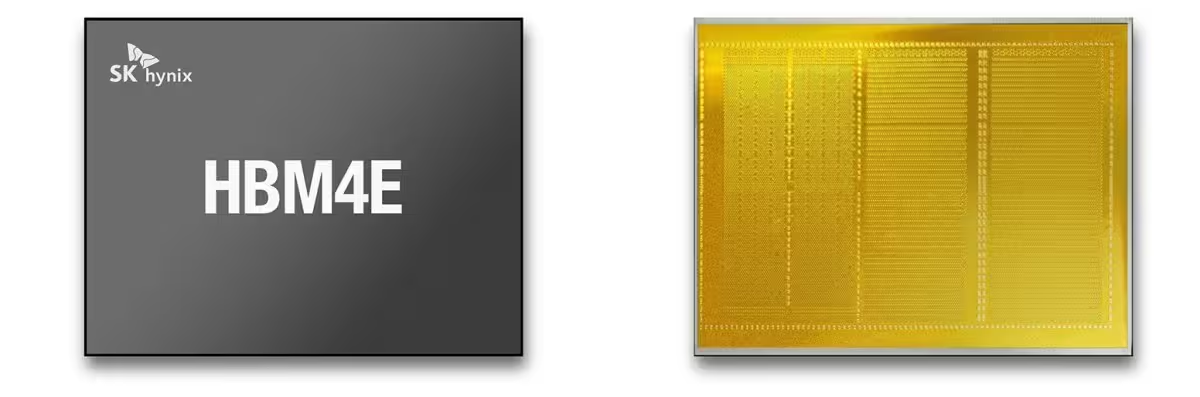
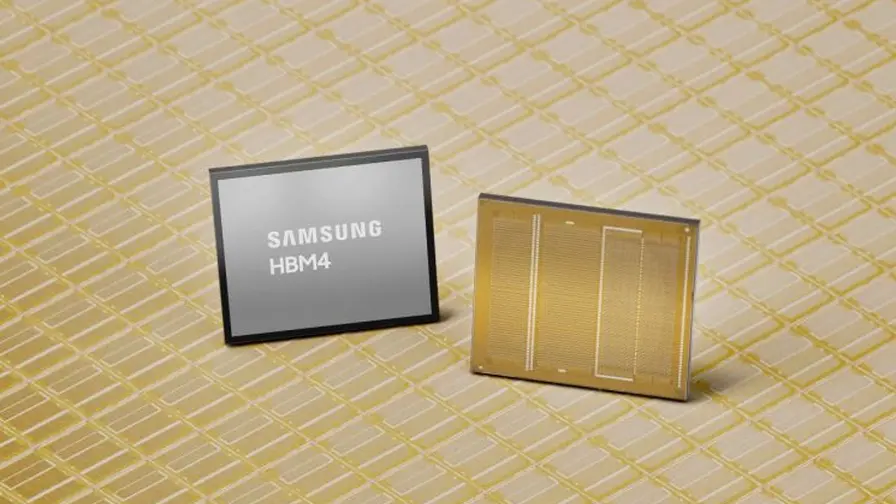
SK hynix HBM4E når 16 Gbps per pin och 48 GB per 12-die-stack.
Företaget staplar 12 kretsar i ett enda paket, vilket ger 48 GB per stack. Det spelar roll eftersom de flesta AI-acceleratorer inte förlitar sig på bara en stack; de sammanfogar flera HBM-stackar för att mata massiva matriser på chipet. Mer kapacitet per stack förenklar kretskortdesign och minskar paketeringskomplexiteten för täta acceleratormoduler.
Effekt är där denna generation gör ett pragmatiskt uttalande. SK hynix uppger att HBM4E är ungefär 20 procent mer energieffektivt än föregående HBM4. Förbättrad effektivitet är den osjungna hjälten för AI-deployering; du kan öka bandbredden, men om du inte kan göra dig av med värmen försvinner de praktiska vinsterna. SK hynix använder en Mass Reflow Molded Underfill-process (MR-MUF), där man injicerar ett skyddande vätskeunderlag mellan kiselkropparna för att stabilisera paketet. Resultatet: cirka 17 procent lägre termiskt motstånd jämfört med den äldre metoden, vilket hjälper kylsystemen att andas lättare.
Varför spelar termiskt motstånd så stor roll? För i en värld där rack är fullpackade med acceleratorer förlänger varje sparad watt och varje grad lägre junctiontemperatur driftsäkerheten och förenklar datacentrets kylbudget. Ingenjörer ogillar överraskningar. Lägre termiskt motstånd är den typen av förutsägbar förbättring som de kan bygga produktplaner kring.
Det finns också bredare konsekvenser. Snabbare pins och högre täthet i stackarna låter chiparkitekter ompröva interposer-layout och minneskanaler. De kan antingen pressa ren beräkningskraft hårdare eller skala upp modeller som tidigare störts av minnesbegränsningar. I klartext: större modeller, tätare inferens eller samma modeller som körs billigare och svalare.
SK hynix beskrev provleveranserna som en milstolpe enligt tidsplan, stödd av företagets produktionserfarenhet. Budskapet är tydligt: företaget räknar med att partner börjar kvalificeringsarbetet och går mot massproduktion. Timing är viktig för kunder som planerar lanseringar av kisel och moduler; tidig tillgång till prover förkortar den processen.
Inte alla AI-arbetslaster behöver det senaste. Men för hyperscalers och AI-hårdvarustartups som jagar maximal genomströmning blir HBM4E:s kombination av bandbredd, kapacitet och termiska förbättringar frestande. Kommer det att omforma nästa våg av acceleratorer? Kanske. Nästa fråga är hur snabbt ekosystemet, interposers, kylare och systemarkitekter, anpassar sig för att utnyttja det spelrum dessa stackar ger.
Om du bryr dig om AI-hårdvarans framtid, håll koll på minnet. Det förändrar ofta tävlingen utan mycket väsen, tills det plötsligt inte längre är tyst.
"Som teknikreporter skriver jag om digital kultur, sociala medier och människans relation till maskiner. Jag gillar när tekniken blir personlig."
Diskussion
Lämna en kommentar
Kommentarer
Inga kommentarer ännu. Bli den första.